
标准 SSD 形态,
增加 AI 数据能力

Infplane AI SSD 提供 M.2 / U.2 产品形态与 PCIe 4.0 / 5.0 主机接口,覆盖 128GB–4TB 容量范围及 SLC / TLC 闪存方案。产品保留标准 NVMe 存储能力,并面向模型权重、KV Cache 与 Agent Memory 优化数据路径。
Interface
PCIe 4.0 / 5.0
覆盖不同主机平台与产品定位
Form Factor
M.2 / U.2
面向笔记本、工作站与整机平台
Capacity Range
128GB–4TB
覆盖主流本地 AI 存储容量
NAND Options
SLC / TLC
适配不同性能、耐久与成本需求
Endurance Management
持续 AI 负载下的稳定耐久
不只存储,
也参与模型运行
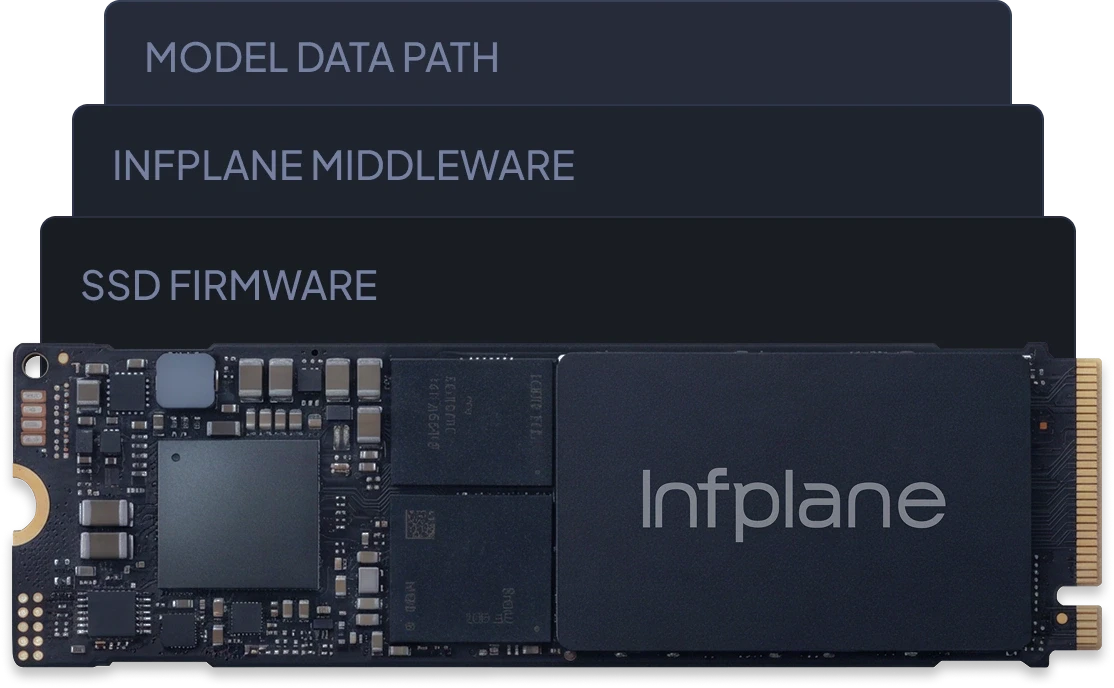
产品组成
从模型应用到 AI SSD
硬件与推理调度层协同工作,让 AI 能力可直接接入本地应用与模型框架。
应用与模型框架
本地 AI 应用 · Agent
调用Infplane推理调度层
Middleware · Driver · Firmware
调度Infplane AI SSD
Maxio 主控 · SLC / TLC NAND · M.2 / U.2
硬件内存与存储协同
模型数据按需放置与恢复
Infplane AI Middleware 根据模型运行状态,在计算内存与 AI SSD 之间执行预测、预取、持久化和恢复。
VRAM
活跃计算数据
DRAM
运行工作集
AI SSD
SLC / TLC NAND
Model Weights
分层 · 预测预取
KV Cache
持久化 · 恢复
Agent Memory
本地保存 · 检索
普通 SSD 负责保存和读取文件; Infplane AI SSD 进一步通过模型感知的数据调度,在 VRAM、DRAM 与 NAND 之间组织模型权重、KV Cache 与长期记忆。相关机制源自 Infplane LPU 模型数据通路技术。
三项核心 AI 能力
在保留标准 SSD 功能的同时,Infplane AI Middleware 与 Driver、Firmware 及 AI SSD 硬件协同,为本地模型提供 Prefill 加速、模型容量扩展与 Agent Memory,并可集成至本地应用与设备平台。

Persistent KV Cache
Prefill 加速
针对 prefixed 与 non-prefixed 长上下文管理 KV Cache。对可复用上下文进行持久化与恢复,减少重复 Prefill,并降低首 Token 时延(TTFT)。

NAND + DRAM / MoE Prefetch
模型容量扩展
通过硬件级 NAND+DRAM 协同与 MoE 数据块预测预取,让模型权重在 DRAM 与 NAND 之间按需调度。在相同计算平台上,可承载更大的本地模型;在固定模型目标下,也可降低对高容量 DRAM / VRAM 的依赖。

Agent Memory Database
Agent Memory
内置 Memory 数据库能力,在设备侧完成跨会话记忆的持久化、索引与检索加速。不同 AI 应用可以通过统一接口调用同一套本地 Memory。
实测表现
查看 AI SSD 在共享上下文任务中的加速效果,以及在不同设备上带来的模型容量提升。
共享上下文,减少重复计算
在相同共享前缀任务中,AI SSD 复用已计算的 KV Cache,缩短 Prefill 时延、首 Token 时延(TTFT)和任务总耗时。
平均耗时
时延(TTFT)
总运行时间
本组数据展示了共享前缀任务中,使用 AI SSD 复用 KV Cache 带来的加速效果。
实际加速效果可能因模型、输入长度、共享前缀比例和硬件配置等因素而异。
数据来源:公司内部基于多款市售设备,在设定测试条件下所得的平均结果。
AI SSD 利用 NAND 容量补充有限的 DRAM / VRAM,让同一台设备能够运行更大的本地模型。图中聚焦模型容量;实际推理速度由处理器、模型与量化配置共同决定。
更大的模型,运行在本地
轻薄本
32GB DRAM · 无独立显卡
游戏本
32GB DRAM · 8GB VRAM
Hilbert Workstation
AMD Strix Halo · 128GB Unified
本组数据对比了不同硬件配置下,“仅使用设备内存”与“设备内存 + AI SSD”两种方案的本地可运行模型规模。
实际可运行的模型规模取决于模型架构、量化格式和设备实时可用内存等因素。
数据来源:公司内部基于与图示对应的硬件配置进行的测试结果。
平台与生态兼容
标准 NVMe 存储功能可直接使用;Infplane AI Middleware 与匹配的 Driver、Firmware 协同启用模型数据调度与推理加速。目前支持 Windows、x86 主机平台与 llama.cpp 生态。
主机平台
操作系统
推理框架与模型
产品规格
Infplane AI SSD 提供 PCIe 4.0 / 5.0 接口、M.2 / U.2 产品形态、128GB 至 4TB 容量规格与 SLC / TLC 闪存方案,面向笔记本、工作站与整机平台。